








Wiele firm gromadzi dokumenty latami, często bez spójnej struktury i w różnych formatach. Nowoczesne systemy AI (np. asystenci agentowi, RAG-i) potrafią znacząco usprawnić pracę, ale ich efektywność jest ograniczona jakością danych wejściowych. Po długim czasie rozrastania się archiwum nie tylko traci ono jakikolwiek porządek, ale często nie ma jednej osoby, która miałaby pojęcie, co się w nim znajduje. To kiepski start do wdrożenia AI: bez znajomości danych trudno zaplanować ulepszenia, a bałagan zwykle odbija się na wynikach.
W artykule przybliżę projekt, który bada, jak stosunkowo niewielkim kosztem rozpoznać ogólną zawartość i wydobyć strukturę z nieuporządkowanego zbioru dokumentów. Użyte metody mogą być wartościowe pod kątem samego rozpoznania treści lub mogą być wstępem do automatycznego (lub półautomatycznego) uporządkowania i opisania repozytorium.
W ramach proof-of-concept zawężamy zakres i:
- skupiamy się na nienadzorowanym wydobyciu struktury z korpusu dokumentów,
- eksperymentujemy z reprezentacjami opartymi nie tylko na tekście, ale również na układzie strony i formie wizualnej,
- badamy, jak grupować dokumenty w sposób interpretowalny i jak uczynić odkrytą strukturę łatwą do odczytania.
Kontekst
Modelowanie tematów
Znajdowanie struktury w korpusie tekstowym nie jest nowym problemem i historycznie używano do tego metod opartych na statystykach słów.
Klasycznym przykładem jest LDA (Latent Dirichlet Allocation): każdy dokument traktowany jest jako mieszanka tematów (mixture of topics), a każdy temat jako rozkład na zbiorze słów, bazujący na tym, które słowa mają tendencję do współwystępowania.
LDA nadal bywa przydatne, ale ma wyraźne ograniczenia. Opiera się wyłącznie na tekście, więc pozostałe informacje zawarte w dokumencie (np. rozkład tekstu, tabele, wykresy czy format wizualny) zostają odrzucone. Poza tym, metoda operuje na liczbie wystąpień słów i fraz (bag-of-words), przez co umyka jej subtelniejsza semantyka, którą potrafią uchwycić dzisiejsze modele językowe.
Klastrowanie (clustering) podchodzi do tego inaczej. Nie rozkłada dokumentu na tematy, tylko zestawia ze sobą dokumenty podobne w wybranej reprezentacji wektorowej (embedding), a ta nie musi ograniczać się do bag-of-words.
Klastrowanie oparte na embeddingach
Dziś takie grupowanie robi się zwykle w przestrzeni embeddingów (najczęściej na bazie sieci neuronowych, choć TF-IDF również się sprawdza).
Schemat jest z grubsza podobny:
embeddingi → redukcja wymiarowości → klastrowanie
Konkretnym przykładem tego podejścia zastosowanego do tekstu jest BERTopic, który bazuje na następujących elementach: embeddingi zdań (sentence embeddings) → UMAP → HDBSCAN. Następnie BERTopic wyznacza reprezentacje tematów na podstawie częstości słów.
Tutaj używamy podobnego podejścia do klastrowania, ale skupiamy się przede wszystkim na doborze embeddingów.
Dokument to więcej niż tekst
Dokumenty niosą więcej informacji niż tylko semantykę tekstu. Układ i styl wizualny, a nawet elementy graficzne, to wartościowe sygnały, które mogą być dla nas kluczowe przy grupowaniu. Sprawdzamy więc, jak wybór embeddingu wpływa na powstałe klastry i które z sygnałów wychodzą na wierzch.
Interpretowalność klastrów
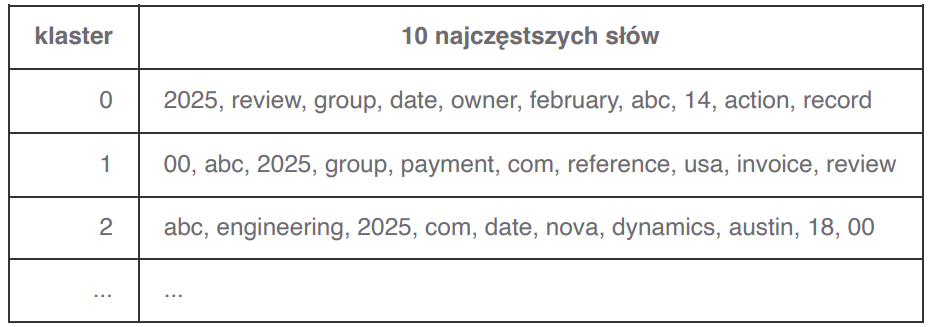
LDA i BERTopic opisują znalezione klastry (tematy) listą charakterystycznych słów lub fraz. Bywa to użyteczne, ale nie wystarczy, żeby klastry łatwo zrozumieć ani uporządkować. Z listy słów można wyczytać i zgadnąć motyw przewodni grupy, ale wymaga to wysiłku. Nie jest też łatwo zbudować przydatną strukturę na bazie takiej reprezentacji.
Poniższe przykłady pokazują, jak LDA i BERTopic opisują tematy. Oba przykłady pochodzą z naszego syntetycznego korpusu (opisanego niżej w sekcji Dane).
LDA (3 z 6 tematów):
BERTopic (3 z 30 tematów):
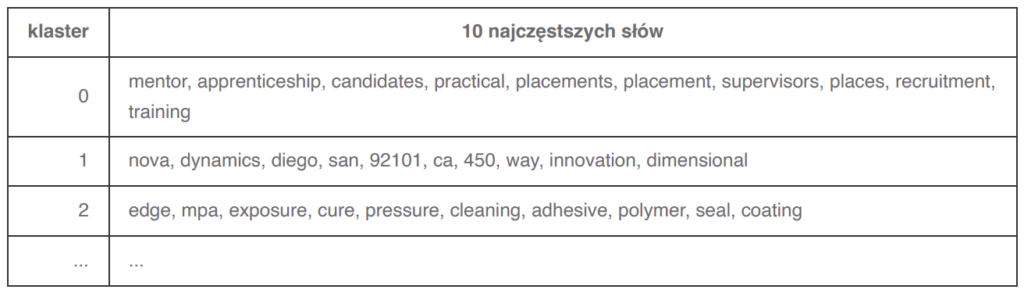
Dlatego oprócz porównania embeddingów i metod klastrowania badamy też czytelniejszy sposób opisywania i strukturyzowania powstałych grup.
Eksperymenty
Zaczynamy od samego klastrowania, a do interpretowania i układania klastrów wracamy w dalszej części.
Dane
Własny zbiór syntetyczny: Aby móc analizować wyniki względem różnych sygnałów, wygenerowaliśmy syntetyczny zbiór danych z trzema z góry zdefiniowanymi, w pełni skrzyżowanymi osiami:
- topic (5): Cybersecurity, Human Resources, Legal & Compliance, Research & Development, Sales & Customer Relations,
- document_type (5): Report, Email, Invoice, Meeting Minutes, Presentation,
- style (3): trzy wyraźnie różne szablony wizualne (fonty, kolory, konwencje układu).
Każdą kombinację przekazaliśmy do LLM-a, który wygenerował dokument w HTML, a ten skonwertowaliśmy do PDF i PNG. Powstały zbiór zawiera 600 dokumentów (5 × 5 × 3, po 8 dokumentów na kombinację). Dla uproszczenia notacji w wynikach odnosimy się do tego zbioru jako: custom.
Dokumenty z prawdziwego korpusu sprawdziłyby się lepiej pod kątem realistycznego oszacowania efektywności; niestety, otwarte zbiory z faktycznymi dokumentami (nie samym tekstem) i z etykietami są trudne do znalezienia.
RVL-CDIP: Aby przeprowadzić testy na prawdziwych danych, skorzystaliśmy ze zbioru RVL-CDIP, który zawiera skany starych dokumentów z branży tytoniowej. To standardowy zbiór w badaniach nad klasyfikacją i klastrowaniem dokumentów na podstawie obrazu. Każdy dokument ma etykietę jednego z 16 typów. Skany są niskiej jakości, co wprowadza sporo szumu. Dla ograniczenia kosztów obliczeń wzięliśmy po 50 próbek na typ, czyli łącznie 800 dokumentów.
Przygotowanie danych
Dla RVL-CDIP użyliśmy OCR-u (optycznego rozpoznawania znaków) w Azure Content Understanding, aby wydobyć tekst z obrazów (jako .md, ale praktycznie bez formatowania). Dla własnego zbioru mieliśmy dostępne PDF-y, więc wystarczył Docling, aby wydobyć .md, które może zawierać część informacji o układzie.
Użyte embeddingi
Aby zbadać reprezentacje niosące różny rodzaj sygnału, wybraliśmy kilka rodzin embeddingów od czysto tekstowych, przez multimodalne (umiejące przetwarzać zarówno tekst jak i obraz), do typowych modeli używanych w przetwarzaniu obrazów. Embeddingi tekstowe liczyliśmy na wyekstrahowanym markdownie, a embeddingi obrazowe na PNG strony.
- Cohere Embed v4 (text, image): multimodalny embedding dokumentów; obie modalności trafiają do jednej wspólnej przestrzeni; wariant obrazowy trenowany był na dokumentach, więc najprawdopodobniej czyta również tekst,
- text-embedding-3-small: typowy embedding tekstu ogólnego przeznaczenia,
- CLIP, SigLIP: ogólne modele wizyjno-językowe trenowane do kojarzenia obrazów z podpisami,
- DINOv2, DiT: modele wizyjne bez nadzoru językowego (DiT trenowany na zeskanowanych dokumentach),
- TF-IDF, pixel: thumbnail: nieneuronowe punkty odniesienia, ważone wektory słów lub fraz (rodzaj bag-of-words) oraz strona jako spłaszczony obraz 32×32 w skali szarości (testowaliśmy też kilka innych baseline’ów pikselowych).
Obie modalności Cohere dzielą jedną przestrzeń, więc możemy eksperymentować z ich łączeniem:
- image − text: sprawdzenie hipotezy: przy wspólnej przestrzeni odjęcie reprezentacji opartej wyłącznie na tekście może „usunąć” semantykę i wzmocnić pozostałe sygnały,
- image + text: niesie oba sygnały w jednym wektorze o tym samym wymiarze.
Wyniki klastrowania
Każdy embedding przepuściliśmy przez PCA, aby zredukować wymiarowość do 32 komponentów, i pogrupowaliśmy używając k-means. Daje to stabilną konfigurację, która pozwala zbadać, jak dobrze różne modele embeddingów radzą sobie z poszczególnymi osiami, bez nadmiernego szumu, który wprowadziłby dodatkowe parametry i ustawienia.
Testowaliśmy również UMAP i HDBSCAN (jak w BERTopic), ale wyniki były mniej stabilne i nie były wyraźnie lepsze lub gorsze, więc zostaliśmy przy PCA i k-means, by skupić porównanie na samych reprezentacjach. Zdolność HDBSCAN-u do odkładania na bok outlierów (obserwacji odstających) czyni go bardzo atrakcyjnym kierunkiem, wartym dalszego zbadania, ale wymaga dobrego dostrojenia parametrów, żeby dobrze działać.
Jako punkt odniesienia użyliśmy BERTopic (na domyślnych embeddingach MiniLM) i LDA (obie metody z lekko dostrojonymi hiperparametrami) oraz losowy podział na grupy. TF-IDF i prosty baseline pikselowy służą do porównania, ile da się osiągnąć znacznie prostszą reprezentacją.
Jakość mierzyliśmy względem dostępnych etykiet (zdefiniowanych osi we własnym zbiorze oraz etykiety typu w RVL) za pomocą czystości (purity), którą definiujemy jako odsetek dokumentów zgodnych z dominującą klasą w każdym klastrze (w uproszczeniu: jak czyste są klastry). Purity rośnie naturalnie wraz z liczbą klastrów, więc zestawiamy konfiguracje o ich zbliżonej liczbie, oznaczonej w tabeli jako k.
Wyjątkiem jest BERTopic, ponieważ HDBSCAN nie daje możliwości ustawienia z góry k, ale i tak wypada słabo na swoich domyślnych embeddingach.
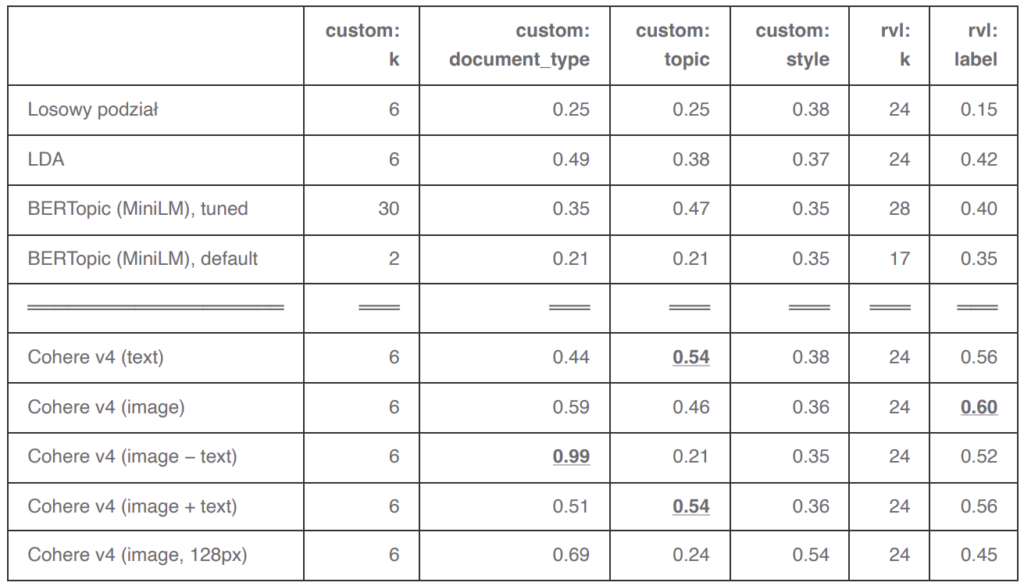
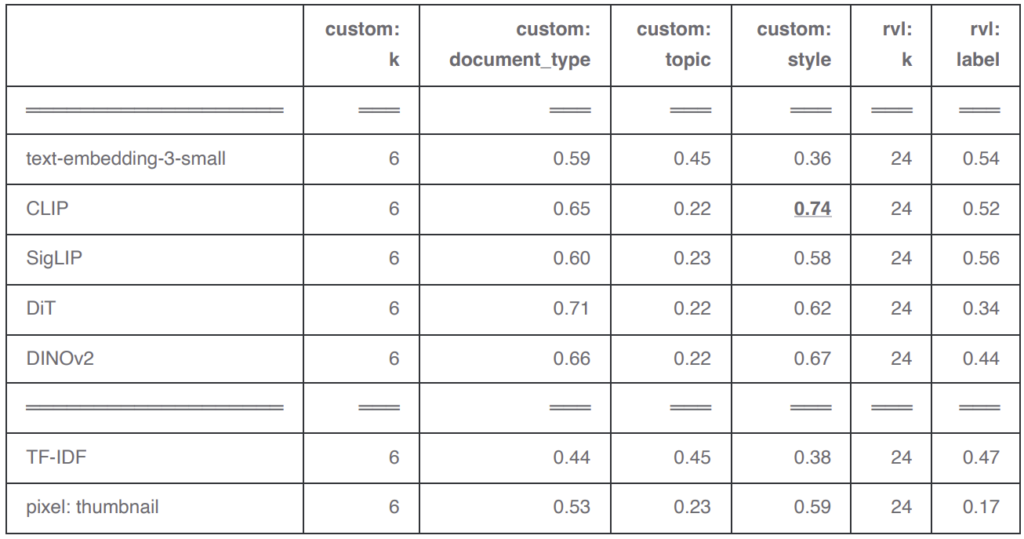
Nie jest zaskoczeniem, że embeddingi wizualne (CLIP, SigLIP, DINOv2, DiT) osiągają lepsze wyniki dla stylu i typu dokumentu, podczas gdy embeddingi świadome tekstu dobrze sprawdzają się przy grupowaniu po temacie. Na RVL najlepiej wypadł Cohere v4 (image), choć margines nad kolejnymi modelami jest na tyle mały, że może być dziełem przypadku. Poradził sobie nieźle również z typem dokumentu i tematem w naszym syntetycznym zbiorze, co ma sens, bo to embedding dedykowany dokumentom i prawdopodobnie czyta tekst.
Odjęcie embeddingu Cohere v4 (text) od embeddingu Cohere v4 (image) zdaje się usuwać semantykę potrzebną do grupowania tematycznego i daje reprezentację, która na zbiorze syntetycznym rozdziela typy dokumentów niemal bezbłędnie. Czy to będzie się dobrze generalizować przy innych danych, nie wiemy, ale sam wynik jest bardzo ciekawy.
Semantykę można wyciszyć również prościej: pomniejszyć stronę na tyle, żeby tekst przestał być czytelny, i na bazie takiego obrazu obliczyć embedding (wiersz Cohere v4 (image, 128px)). Poprawia to klastrowanie po typie dokumentu (choć znacznie słabiej niż odejmowanie) i podbija też styl. Ciekawa obserwacja, choć w praktyce raczej mało użyteczna.
Wykorzystanie więcej niż jednego embeddingu
Większość embeddingów dała dobre wyniki tylko na jednej z osi. Dlatego zamiast klastrować raz, moglibyśmy spróbować zrobić to kilkukrotnie, za każdym razem z innym embeddingiem lub konfiguracją skierowanymi na inny sygnał.
W kolejnych eksperymentach sprawdziliśmy, czy klastrowanie dwupoziomowe pozwala odzyskać więcej niż jedną oś naraz.
Podejście
Rozważaliśmy różne pomysły na połączenie dwóch poziomów klastrowania:
- grupujemy niezależnie każdym embeddingiem i bierzemy iloczyn kartezjański przypisań jako ostateczne klastry,
- drugim embeddingiem klastrujemy osobno wewnątrz każdego klastra poziomu 1 (tracimy motywy przechodzące między klastrami, ale może się to dobrze skalować na większych korpusach),
- przed drugim grupowaniem od każdego embeddingu odejmujemy centroid klastra z pierwszego poziomu, nie dzieląc danych na części, po czym bierzemy iloczyn jak w pierwszej metodzie.
W eksperymentach najlepiej wypadł ostatni wariant (więc na nim oparliśmy wyniki), choć różnice były na tyle małe, że trudno było wyciągnąć jednoznaczne wnioski. To może być ciekawy kierunek dalszych usprawnień.
Prostszą alternatywą jest konkatenacja dwóch embeddingów i jednorazowe klastrowanie we wspólnej przestrzeni.
Wyniki
Na każdym poziomie utworzyliśmy 6 klastrów i zwinęliśmy te, które okazały się zbyt małe. Dla porównania z prostszą metodą łączenia sygnałów zestawiamy podejście dwupoziomowe z płaskim klastrowaniem przy zbliżonej liczbie klastrów.
W poniższej tabeli oznaczamy te konfiguracje następująco:
- flat: pojedyncze klastrowanie na danym embeddingu.
- flat: concat(A, B): pojedyncze klastrowanie na dwóch embeddingach sklejonych w jedną szerszą przestrzeń.
- 2lvl: A → B: klastrowanie dwupoziomowe, poziom 1 na embeddingu A, poziom 2 na B.
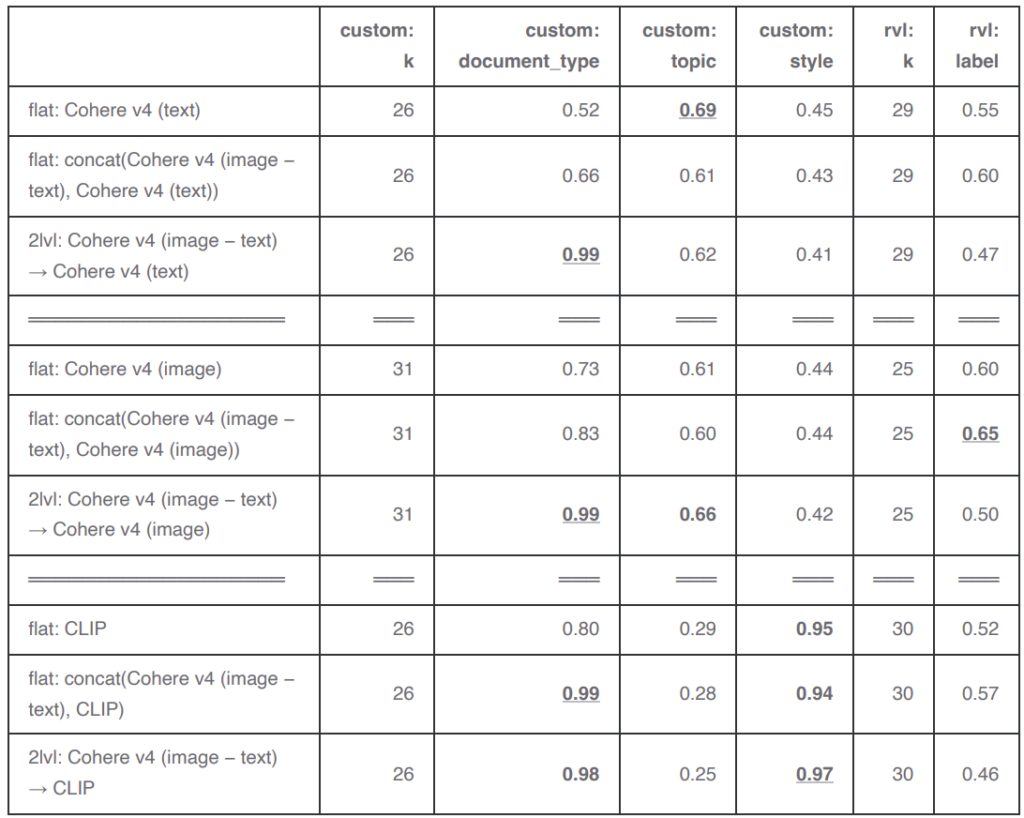
Klastrowanie dwupoziomowe zachowuje niemal bezbłędny wynik na typie dokumentu, a przy tym temat albo styl (w zależności od konfiguracji) zostaje na poziomie zbliżonym (lub tylko nieco gorszym) do płaskiego grupowania. Dostajemy więc dwa użyteczne podziały zamiast jednego, przy tej samej łącznej liczbie grup.
Dla RVL wyniki się pogarszają, co nie jest zaskoczeniem. W tym zbiorze oznaczona etykietami jest tylko jedna oś, a klas jest 16, przez co zmniejszenie liczby grup na każdym poziomie ograniczyło możliwość odwzorowania tego podziału.
Tutaj najlepiej wypadło podejście z konkatenacją, więc łączenie dwóch poziomów sygnału nadal jest korzystne. Sugeruje to, że ustalona z góry liczba klastrów na każdym poziomie może się słabo generalizować (np. gdy dane mają dużą zmienność semantyczną, ale jednorodny format lub odwrotnie). Dynamiczne dobranie liczby klastrów do konkretnych danych (np. używając HDBSCAN lub opierając się na heurystykach) ma szansę poprawić uniwersalność tego podejścia, co może być kluczowym kierunkiem jego rozwoju.
Grupowanie i interpretowalność
Jak pokazaliśmy wcześniej, ani LDA, ani BERTopic nie dają nam użytecznych etykiet ani opisów klastrów.
Aby opisać i grupować otrzymane klastry, wykorzystujemy podejście oparte na LLM-ach.
Przepuszczanie wszystkich dokumentów przez LLM byłoby dość kosztowne przy dużym korpusie, dlatego, aby zachować wydajność, dla każdego klastra wybieramy N próbek (tutaj N=5, ale to parametr do dostrojenia) i pokazujemy je modelowi do interpretacji. W tej analizie wybieraliśmy je losowo, ale warto byłoby poeksperymentować z wyborem dokumentów najbardziej reprezentatywnych albo o najszerszym pokryciu.
Realizujemy to w dwóch fazach:
- INTERPRET: model opisuje klaster, nadaje mu krótką nazwę i wskazuje cechy wspólne dla wszystkich pokazanych przykładów (dziedzina, typ dokumentu itp.).
- NORMALIZE / GROUP: przekazujemy wszystkie powstałe interpretacje naraz i prosimy model o ujednolicenie nazewnictwa oraz pogrupowanie klastrów według wspólnych cech.
Z długiej listy klastrów robi się w ten sposób krótszy zestaw nazwanych, spójnych grup wraz z osiami, wzdłuż których można je układać.
Wyniki
Wyniki etykietowania i grupowania klastrów przedstawiamy w formie drzewa: najwyższy poziom to grupowanie zaproponowane przez model wzdłuż jednej cechy, a kolejne zagnieżdżone poziomy to podziały wzdłuż następnych.
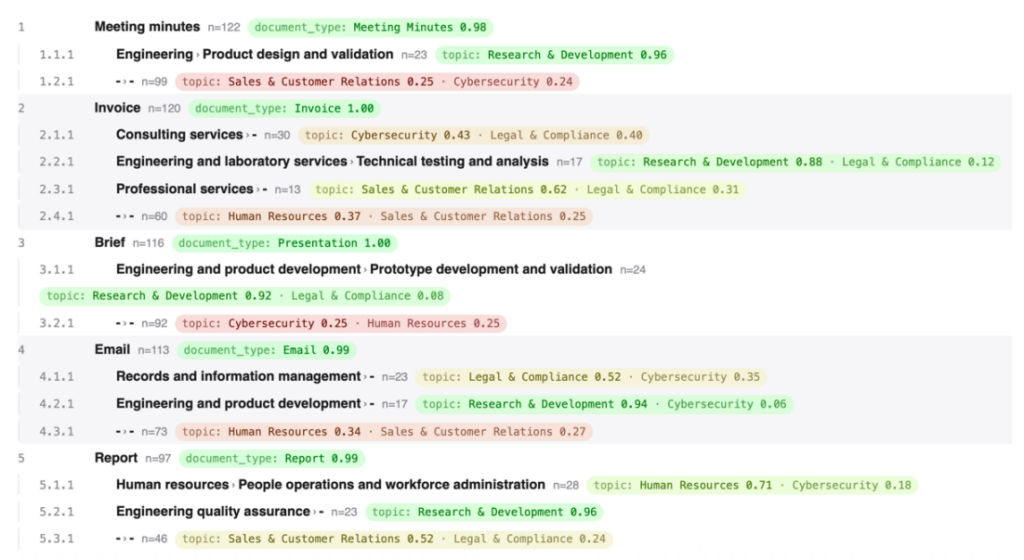
Poniżej pokazujemy kilka pierwszych grup z dwóch konfiguracji (opartych na dwupoziomowym klastrowaniu z poprzedniej sekcji): jednej rozdzielającej typ dokumentu i temat, drugiej typ dokumentu i styl.
Kolorowe paski pokazują dla każdej grupy dwie najczęstsze klasy referencyjne na bazie ground truth. Te etykiety zostały dodane dopiero później, wyłącznie na potrzeby analizy, aby pokazać, jak zachowuje się nazewnictwo dla grup czystych i wymieszanych. Samo klastrowanie, opisywanie i grupowanie odbyło się w pełni bez nadzoru.
A. 2lvl: Cohere v4 (image − text) → Cohere v4 (text): pogrupowane po typie dokumentu (poziom 1) i dziedzinie (poziom 2)
B. 2lvl: Cohere v4 (image − text) → CLIP: pogrupowane po typie dokumentu (poziom 1) i stylu wizualnym (poziom 2)
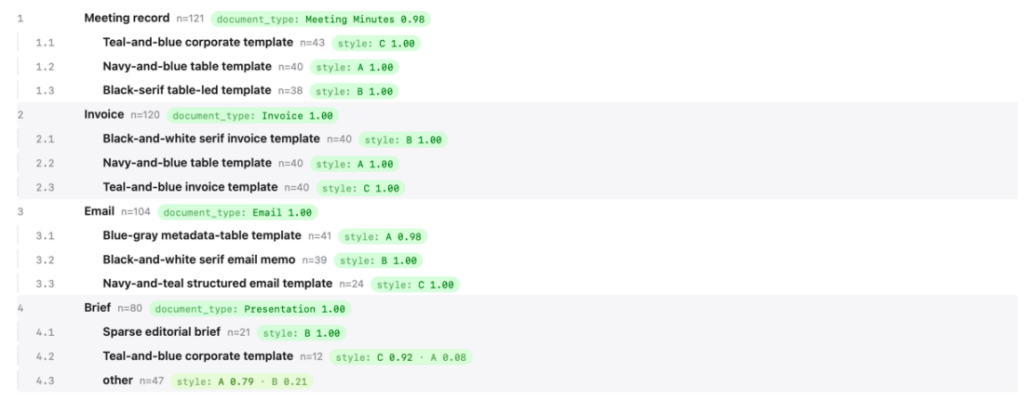
Tam, gdzie klastrowanie zadziałało dobrze, grupy są trafnie nazwane i sensownie poukładane. Etykiety są bardziej ogólne dla wymieszanych klastrów i mniej z nich udaje się skutecznie połączyć. Zauważalna część klastrów w ogóle nie trafia do żadnej grupy, bo model łączy tylko te, które mają wyraźne cechy wspólne. Natomiast grupy, które udaje się utworzyć, zostają sensownie opisane przez model.
Choć na tym etapie rozwiązanie jest niedoskonałe, taki podział daje szybki, ogólny wgląd w to, co zawiera dany korpus. Gdyby udało się wiarygodnie oceniać, które klastry są spójne, i wskazywać w grupach elementy odstające, to wyniki można by przekazać człowiekowi (human-in-the-loop) czy nawet mocniejszemu modelowi w celu przeglądu i korekty, tworząc tym samym wydajny i względnie szybki proces porządkowania dużych repozytoriów dokumentów.
Ograniczenia i dalsze kierunki
Niektóre elementy zostały uproszczone lub pozostały poza zakresem projektu (co jest naturalne dla proof-of-concept) i powinny zostać rozwinięte, gdyby projekt był kontynuowany.
- Dane – dla uproszczenia użyliśmy pojedynczych stron. Syntetyczny korpus pozwolił wyizolować różne rodzaje struktury (semantyczną, wizualną, układu), ale nie stanowi solidnej podstawy do szacowania bezwzględnej skuteczności rozwiązania. RVL-CDIP jest zbiorem rzeczywistym, lecz niskiej jakości i niereprezentatywnym dla współczesnego archiwum dokumentów. Właściwym benchmarkiem byłby duży, rzeczywisty, oznaczony korpus, jednak takie zbiory są trudne do pozyskania.
- Ewaluacja – metody są nienadzorowane, ale etykiety referencyjne (ground truth) zostały wykorzystane przy doborze modelu. Staraliśmy się unikać raportowania konfiguracji, których dobry wynik mógł być dziełem przypadku, i skupiliśmy się na obserwacjach spójnych w różnych ustawieniach, jednak wyniki uzyskane na tych danych mogą nie generalizować się na inne przypadki. W przyszłych pracach należałoby zastosować bardziej rygorystyczny protokół (dobór modelu i strojenie hiperparametrów na wydzielonym zbiorze).
- Metody – przedstawione metody otwierają dużo kierunków do dalszego zbadania, takich jak dostrojenie samego klastrowania, ocena pewności przypisania poszczególnych dokumentów lub spójności klastrów, czy sposób doboru próbek do etykietowania.
Artificial Intelligence
Dostarczamy rozwiązania AI dopasowane do Twojego biznesu, które zwiększają efektywność i podnoszą produktywność Twojego zespołu.
Oferta AIWnioski
Nasze wyniki pokazują, że dobierając odpowiednio embedding, możemy, do pewnego stopnia, pokierować tym, jaki rodzaj sygnału ma wychwycić klastrowanie. Embedding nie jest z zasady lepszy ani gorszy, ale wyciąga inne informacje z dokumentów. Zbadaliśmy również sposoby łączenia reprezentacji, tak aby klastrowanie mogło ujawnić więcej niż jeden rodzaj struktury naraz.
Ponadto proponujemy szybki sposób etykietowania i porządkowania klastrów w czytelne grupy i podgrupy. Podejście jest przy tym oszczędne, ponieważ jego kosztowna część (LLM) skaluje się z liczbą grup, a nie z liczbą dokumentów.
Przedstawione metody mogłyby posłużyć jako narzędzie do rozpoznawania treści, ujawniając motywy i strukturę w dużych zbiorach dokumentów. Żeby mieć pewność, że sprawdzą się także na innych danych, wyniki wymagałyby dalszej weryfikacji, a do półautomatycznego porządkowania repozytoriów metodę trzeba będzie jeszcze dopracować (m.in. pod kątem niezawodności).
Mimo to eksperymenty pokazują, że da się wydobyć sensowną strukturę z nieuporządkowanych dokumentów i przedstawić ją w czytelnej formie.
Źródła
Modele tematyczne i metody klastrowania
- LDA – Blei, D. M., Ng, A. Y., Jordan, M. I. (2003). Latent Dirichlet Allocation. JMLR 3, 993–1022. https://www.jmlr.org/papers/volume3/blei03a/blei03a.pdf
- BERTopic – Grootendorst, M. (2022). BERTopic: Neural topic modeling with a class-based TF-IDF procedure. arXiv:2203.05794. https://arxiv.org/abs/2203.05794
- Embedding-based clustering – Sia, S., Dalmia, A., Mielke, S. J. (2020). Tired of Topic Models? Clusters of Pretrained Word Embeddings Make for Fast and Good Topics too!. EMNLP 2020. arXiv:2004.14914. https://arxiv.org/abs/2004.14914
- UMAP – McInnes, L., Healy, J., Melville, J. (2018). UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction. arXiv:1802.03426. https://arxiv.org/abs/1802.03426
- HDBSCAN – Campello, R. J. G. B., Moulavi, D., Sander, J. (2013). Density-Based Clustering Based on Hierarchical Density Estimates. PAKDD 2013, 160–172. https://link.springer.com/chapter/10.1007/978-3-642-37456-2_14
Modele embeddingów
- Cohere Embed v4 (text / image, shared embedding space) – Cohere. Embed documentation. https://docs.cohere.com/docs/cohere-embed
- text-embedding-3-small – OpenAI. Embeddings guide. https://platform.openai.com/docs/guides/embeddings
- MiniLM / Sentence-BERT (BERTopic’s default embedding) – Reimers, N., Gurevych, I. (2019). Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks. arXiv:1908.10084. https://arxiv.org/abs/1908.10084
- CLIP – Radford, A. et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. arXiv:2103.00020. https://arxiv.org/abs/2103.00020
- SigLIP – Zhai, X. et al. (2023). Sigmoid Loss for Language Image Pre-Training. arXiv:2303.15343. https://arxiv.org/abs/2303.15343
- DiT – Li, J. et al. (2022). DiT: Self-supervised Pre-training for Document Image Transformer. arXiv:2203.02378. https://arxiv.org/abs/2203.02378
- DINOv2 – Oquab, M. et al. (2023). DINOv2: Learning Robust Visual Features without Supervision. arXiv:2304.07193. https://arxiv.org/abs/2304.07193
Dane i narzędzia
- RVL-CDIP – Harley, A. W., Ufkes, A., Derpanis, K. G. (2015). Evaluation of Deep Convolutional Nets for Document Image Classification and Retrieval. ICDAR 2015, 991–995. https://arxiv.org/abs/1502.07058
- Docling (PDF → markdown extraction) – Auer, C. et al. (2024). Docling Technical Report. arXiv:2408.09869. https://arxiv.org/abs/2408.09869

Zostaw komentarz