








W dzisiejszych czasach, dzięki dynamicznemu rozwojowi informatyki oraz wciąż rosnącej mocy obliczeniowej, mamy dostęp do coraz większej liczby narzędzi wspierających naukowców i profesjonalistów w zadaniach związanych z wizją komputerową.
W tym artykule przyjrzymy się krótko obecnemu stanowi wiedzy z zakresu przetwarzania obrazów cyfrowych. Zobaczymy również, jak to fascynujące zagadnienie sprawdza się w szeroko pojętym przemyśle i w wybranych dziedzinach nauki – ze szczególnym uwzględnieniem segmentacji. Omówimy podział podstawowych technik przetwarzania obrazów i pokażemy kilka ciekawych przykładów z przemysłu i medycyny.
Przetwarzanie obrazów
Przetwarzanie obrazów to dziedzina nauki, która rozwija się w zawrotnym tempie niemal od momentu powstania pierwszych komputerów. Już w 1957 roku Frank Rosenblatt z Uniwersytetu Cornell stworzył pierwszą, prostą sieć neuronową służącą do rozpoznawania cyfr. Niedługo potem, w 1959 roku, panowie David Hubel i Torsten Wiesel badali aktywność kory mózgowej kotów w reakcji na proste kształty. Dzięki temu odkryli, w jaki sposób mózgi ssaków obserwują i rozumieją otaczający je świat. Te przełomowe prace stanowią fundamenty nowoczesnych systemów wizji komputerowej.
Co ciekawe, w swoich podstawowych założeniach algorytmy te nie zmieniły się drastycznie od tamtego czasu, nie licząc oczywiście znaczącego rozbudowania samej architektury sieci. Warto jednak mieć na uwadze, że nawet najbardziej zaawansowane systemy wciąż są daleko w tyle za sposobem, w jaki my (ludzie) postrzegamy świat. Ponadto bywają one mocno podatne na ataki hakerskie wykorzystujące luki w budowie obecnych architektur.
Oprócz zaawansowanych algorytmów uczenia maszynowego istnieje całe mnóstwo prostych modeli matematycznych. Choć powstały dziesiątki lat temu (w latach 60. XX wieku i później), w niezmienionej formie do dziś radzą sobie zadziwiająco dobrze. Niestety, ich główną wadą jest silne ograniczenie do bardzo wąskich, specyficznych zastosowań.
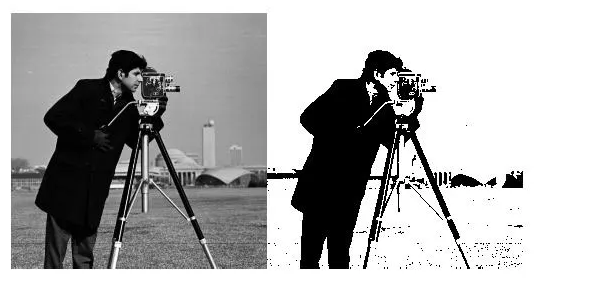
Poniżej możemy zobaczyć typowy problem tzw. binaryzacji dla prostego obrazu w odcieniach szarości.
Nowoczesna wizja komputerowa
Współczesna wizja komputerowa dzieli się na kilka głównych kategorii problemów:
- Przetwarzanie obrazów.
- Detekcja obiektów.
- Segmentacja obrazów.
- Klasyfikacja obrazów.
- Detekcja pozy.
- Detekcja obróconych minimalnych otaczających prostokątów.
Z punktu widzenia zastosowań przemysłowych bez wątpienia najciekawszymi technikami są klasyfikacja oraz segmentacja obrazów.
Klasyfikacja obrazów
Klasyfikacja obrazów to, w uproszczeniu, algorytmy, które – po otrzymaniu zdjęcia – potrafią przypisać mu odpowiednią kategorię z wcześniej znanego zbioru klas. Próby rozwiązania tego problemu rozpoczęły się już w latach 50., jednak przełom nastąpił dopiero wraz z pojawieniem się głębokich sieci neuronowych. Mogliśmy je skutecznie rozwijać głównie dzięki upowszechnieniu się kart graficznych wyposażonych w dużą ilość pamięci RAM.
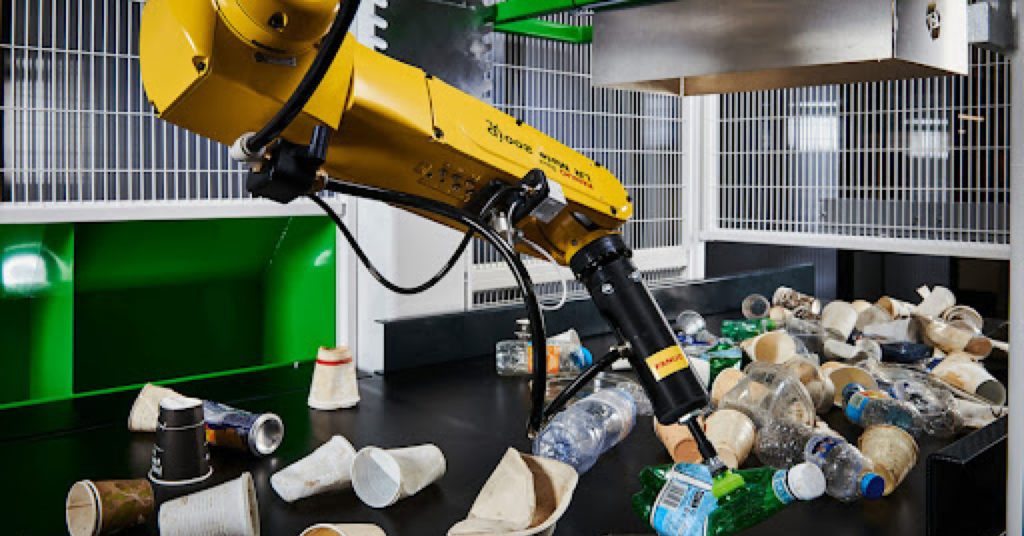
Sama wizja komputerowa gości na liniach produkcyjnych już od lat 70. ubiegłego wieku. To właśnie wtedy powstawały pierwsze, dość drogie i ograniczone w zastosowaniu systemy do rozpoznawania znaków (OCR). Wraz z ewolucją mikroprocesorów, przechodząc z architektury 8-bitowej na 16- i 32-bitową, komputery zaczęły sprawnie przetwarzać i klasyfikować obrazy (nawet jeśli miały one niewielką rozdzielczość). Przykładowo, systemy te potrafiły sortować owoce na taśmie produkcyjnej, analizując ich cechy na podstawie kolorowych zdjęć.
Przejdźmy jednak do teraźniejszości i spójrzmy na kilka ciekawych zastosowań.
Inne zastosowania
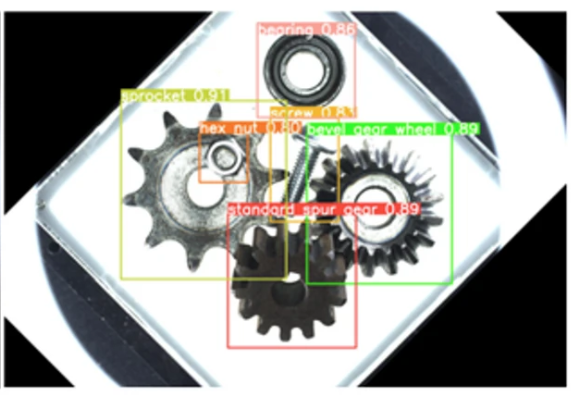
Gdzie jeszcze z powodzeniem łączy się klasyfikację obrazów z algorytmami detekcji obiektów?
- Liczenie i weryfikacja wymiarów komponentów: Algorytm wykrywa krawędzie obiektów, które kontrastują z tłem. Po wyodrębnieniu skupisk pikseli reprezentujących dany przedmiot system zlicza je, a następnie mierzy ich średnicę oraz rozstaw otworów – i to z dokładnością do pojedynczych mikrometrów.
- Kontrola poziomu napełnienia butelek: Kamera robi zdjęcie butelki poruszającej się po linii produkcyjnej z użyciem podświetlenia od tyłu. Następnie system dzieli obraz na obszary cieczy i powietrza na podstawie prostych różnic w jasności pikseli (tzw. progowanie binarne).
- Weryfikacja etykiet: System sprawdza obecność i prawidłowe położenie etykiety na produkcie. Analizując kolor i teksturę, algorytm wyodrębnia obszar, w którym powinna znajdować się naklejka, by potem porównać jej położenie (w tym kąt obrotu i przesunięcie) z idealnym wzorcem.
Ograniczenia
Nie ma rozwiązań idealnych. Technologia klasyfikacji obrazów boryka się z kilkoma wyzwaniami:
- Brak możliwości określenia dokładnego położenia obiektu na zdjęciu.
- Skuteczność modelu mocno zależy od jakości danych treningowych.
- Duża wrażliwość algorytmów na zmiany oświetlenia oraz warunków fotografowania.
- Trudności w poprawnym rozróżnianiu wizualnie podobnych obiektów.
- Wysokie wymagania dotyczące dostępności potężnych, odpowiednio oznaczonych zbiorów danych do osiągnięcia wysokiej dokładności.
- Drastyczny spadek skuteczności w przypadku nowych wariantów przedmiotów lub nieznanego środowiska.
Segmentacja obrazów
Segmentacja to nie lada orzech do zgryzienia, do którego naukowcy wciąż szukają optymalnych modeli matematycznych. Problem polega na tym, że nawet wykwalifikowani eksperci analizujący skomplikowany obraz o niejasnych krawędziach często mają trudności z poprawnym i jednoznacznym wskazaniem granic interesujących ich obiektów.
Mniej skomplikowane zadania segmentacji można dobrze rozwiązać, łącząc klasyfikację obrazów z algorytmami do orientacyjnego lokalizowania obiektów.
W tym przypadku z pomocą przychodzą popularne obecnie narzędzia z rodziny YOLO. Starsze, ale równie pomysłowe podejścia, takie jak RCNN i Faster RCNN, działają na zasadzie odrzucania obszarów obrazu, w których obiekt z pewnością nie występuje, i skupiają się na miejscach, gdzie system dostrzegł jego fragment.
Obrazy dna oka
Sama segmentacja odgrywa ogromną rolę w medycynie. Świetnym polem do badań i eksperymentów są tutaj m.in. obrazy dna oka.
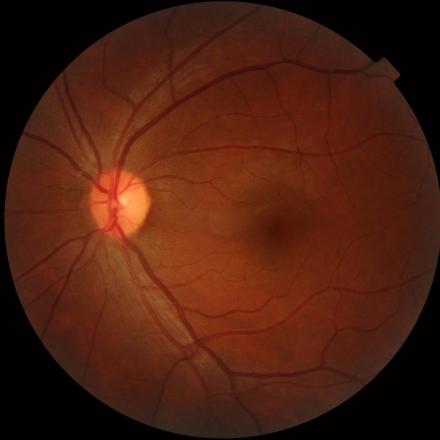
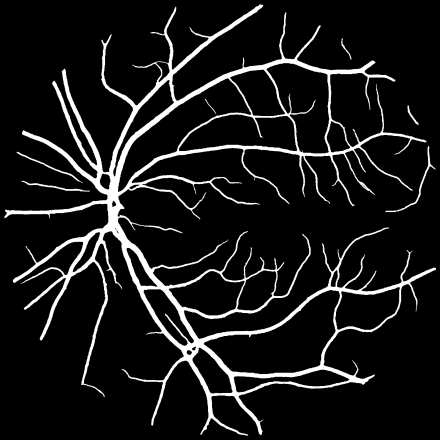
Temat segmentacji obrazów dna oka jest doskonale opisany w literaturze fachowej. Dzięki temu zagadnienie jest świetnie zbadane i służy naukowcom jako poligon doświadczalny do testowania zaawansowanych modeli uczenia maszynowego. Baza literaturowa opiera się na tysiącach artykułów naukowych oraz dziesiątkach znakomicie opracowanych przez lekarzy zbiorów danych.
Co konkretnie bada się na obrazach dna oka?
- Segmentację obrazów w odcieniach szarości u pacjentów, którym podano dożylnie kontrast, oraz zdjęć pochodzących z urządzeń rejestrujących natywnie w skali szarości.
- Wykrywanie zmian patologicznych, takich jak druzy, wysięki czy mikrokrwawienia, które świadczą o rozwijającej się chorobie.
- Detekcję naczyń krwionośnych w celu porównania ich układu ze znanymi i opisanymi normami patologicznymi.
- Wykrywanie zmian w układzie naczyń zachodzących wraz z wiekiem pacjenta (świetne narzędzie diagnostyczne).
- Identyfikację wnęki naczyniowej, dysku optycznego oraz plamki żółtej.
- Wpływ różnych warunków rejestracji obrazu na późniejszą jakość procesu segmentacji.
- Wpływ samej rozdzielczości na proces segmentacji oraz budowę modeli matematycznych odpornych na jej zmianę w technice tzw. segmentacji kafelkowej.
- Generowanie sztucznych obrazów dna oka na potrzeby zautomatyzowanego uczenia w połowie nadzorowanego.
To oczywiście tylko wierzchołek góry lodowej.
Jednym z ciekawszych wyzwań badawczych jest analiza wpływu rozdzielczości na jakość końcowej segmentacji. Zasada jest tu dość przewrotna: wyższa rozdzielczość oznacza więcej widocznych szczegółów, ale wiąże się też z ryzykiem powstawania fałszywych artefaktów.
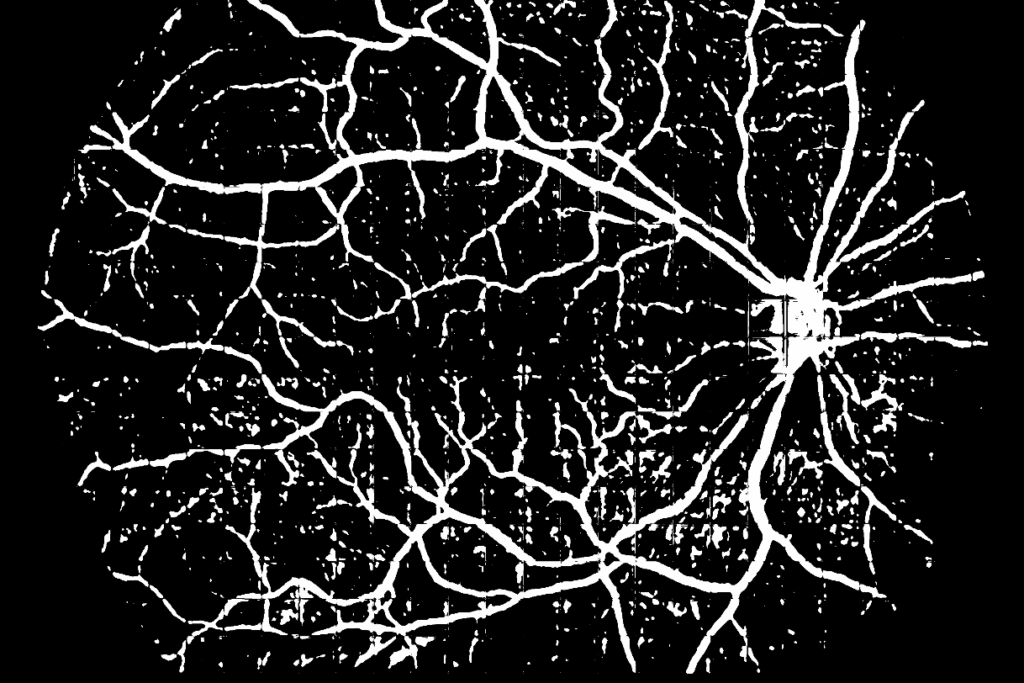
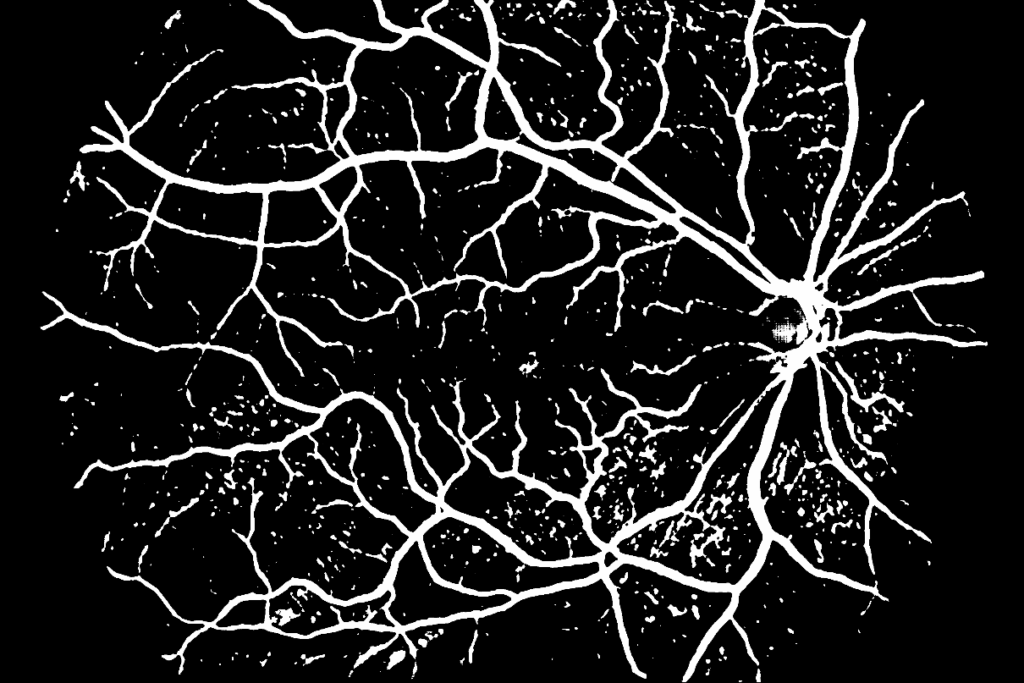
Jak widać w praktyce, rozdzielczość potrafi mieć znaczący wpływ na efekt naszej pracy. Obrazy w wysokiej skali pokazują o wiele gładsze granice naczyń krwionośnych, a ewentualne mankamenty na łączeniach kafelków są znacznie mniej widoczne. Wciąż jednak zdarzają się błędy polegające na urywaniu się ciągłych fragmentów żył czy pojawianiu się wirtualnych „naczyń”, które w rzeczywistości nie istnieją.

Industrial Engineering
Usprawnij działania dzięki naszym rozwiązaniom dla każdego sektora w zakresie projektowania, montażu i Przemysłu 4.0 przy wsparciu ekspertów.
Oferta Industrial engineeringPodsumowanie
W artykule nakreśliliśmy, jakimi wyzwaniami zajmuje się obecnie wizja komputerowa. Narzędzia te dobrze sprawdzają się w typowo przemysłowych procesach, jak również wspierają bardzo ambitne zadania badawcze na styku medycyny i informatyki. Wyzwań i tematów są tutaj setki.
Implementowane rozwiązania pozwalają odciążyć nas od żmudnych, powtarzalnych zadań oraz poprawiać jakość naszego życia. Kto wie, być może w najbliższych latach będziemy mogli dzięki technologii przywrócić częściową zdolność widzenia osobom dotkniętym utratą wzroku? Wyzwania, które przed nami stoją, są duże, ale to czyni je ciekawymi i wartymi dalszych badań.
Literatura uzupełniająca
- Ronneberger, O., Fischer, P., Brox, T. (2015). U-Net: Convolutional Networks for Biomedical Image Segmentation
- U-Net: Convolutional Networks for Biomedical Image Segmentation (Springer Chapter)
- Instance segmentation with Ultralytics YOLO
- Image classification with Ultralytics YOLO
- Computer Vision: Algorithms and Applications, 2nd ed.
Zostaw komentarz